全球药物研发临床失败超 50% 源于靶点选择偏差。具备遗传学证据支撑的靶点,获批概率约为无遗传证据者的 2.6 倍,且该优势随「变异 - 基因」归因置信度提升持续增强——归因置信度直接决定靶点证据的价值。
在 AI 时代,重构生命科学的中心法则
AI for Science · 自进化世界模型 · Sequence-to-Function
构建从序列到表型的自进化世界模型,让其中每一步可计算、可解释、可验证。
自研 Sequence-to-Function 大模型登顶独立基准全球 SOTA,自研 AI Infra 驱动模型持续自进化,Agent 架构打通序列到表型全链路。面向创新药企,打造靶点立项的可审计功能证据平台。
- 独立基准 · 上海人工智能实验室3 / 3
自研模型三个疾病分组全部第一
- 顶刊发表 · 一作与通讯Nature Genetics
Nature Communications团队为核心成果的第一作者与通讯作者
- 公开验证 · 冠心病16,607 → 42
42 个优先候选,独立复现已验证靶点
SEQUENCE × CONTEXT → FUNCTION → PHENOTYPE
02 THE BOTTLENECK
靶点发现:新药研发
最上游、价值最高的核心环节
靶点选择直接决定管线成败,却被三大结构性问题锁死,构成当前研发效率的天花板。
传统靶点发现高度依赖自然样本:需依托人群缺失突变、病人组织功能图谱方可启动立项,行业内成熟靶点长期稀缺,大多依赖偶然发现与验证。
大量非编码变异、剪接调控与 lncRNA 因缺少可审计的功能证据,无法进入研发管线,潜在成药价值被锁在立项之外。
行业亟需一种不依赖自然样本、覆盖非编码区、可持续提升归因置信度的功能证据。这正是 Sequence-to-Function 模型的直接输出。
LinkX 核心团队为 Nvwa、Huatuo、OmniReg-GPT 的第一作者与通讯作者,五年持续深耕序列到功能建模。
数据来源:Minikel EV, Painter JL, Dong CC & Nelson MR. Nature 629, 624–629 (2024). doi:10.1038/s41586-024-07316-0。
03 THE CLOSED LOOP
核心壁垒:持续产出 SOTA 的
自进化模型生产线
LinkX 以三层能力回答「该靶点是否值得干预」:自研模型给出功能判断,自进化模型工厂持续提升判断精度,Agent 架构将判断组合为药企可直接采用的立项证据。每一次客户合作回流为训练信号,形成持续自进化的闭环。
- 01自研 S2F 大模型独立基准全球 SOTA→
- 02自进化模型工厂用 AI 创造 AI→
- 03Agent 架构组合推演超越最强单模型→
- 04药企立项证据包合作回流训练信号↺
OmniReg-GPT 在上海人工智能实验室 CENO 基准上三个疾病分组第一。
DeepGeSeq 自主完成建模、预测、验证与微调,首版微调使 ATAC 误差下降 91.9%。
冻结基准上,S2F Agent 超过按验证集选出的最强单模型,Δ macro Spearman +0.3282。
方法已发表,数据持续回流。闭环持续运转,沉淀为从序列到表型的世界模型。
04 SEQUENCE-TO-FUNCTION
自研 Sequence-to-Function 大模型
登顶独立基准全球 SOTA
上海人工智能实验室发布的 CENO 公开基准中,OmniReg-GPT 在三个疾病分组的 ClinVar F1 均列第一,超过 Evo 2、GPN、HyenaDNA 等国际前沿模型。相关成果发表于 Nature Genetics、Nature Communications。
20 kb 长序列窗口,覆盖表达、染色质可及性、遗传变异与三维基因组任务,是候选压缩环节的主力打分模型。
Nvwa、Huatuo、HERMES 覆盖跨物种表达、细胞类型特异调控与 40 类序列功能簇,构成世界模型的内核。
#01OmniReg-GPTSOTA · ALL 3 GROUPS
#02GPN
#03Grover
#04NTv3-100M
#05CENO-1B-base
#06HyenaDNA-Large-1M
#07Evo2 40B
#08CENO-1B-1m
#09Evo2 40B base
#10CENO-1B-131k
Source: CENO: A Genome-Scale World Model for Evolutionary Sequence Interpretation and Programmable Regulatory Design — Technical Report, Shanghai Artificial Intelligence Laboratory (2026), Supplementary Fig. S5b. Zero-shot ClinVar F1 grouped by clinical category; comparison scope limited to the models displayed in that figure.
核心成果 PUBLISHED TRACK RECORD
四个自研模型构成世界模型内核
团队成员为相关成果的第一作者或通讯作者。
2022 · Nature GeneticsNvwa
- 核心成果
- 跨物种、单细胞分辨率的序列到表达深度学习模型;AUROC 0.78 / AUPR 0.59,跨 8 个物种验证,测试基因未参与训练。
- 闭环定位
- 跨物种「序列→细胞状态」基座模型,为世界模型提供细胞语境下的功能判断基础。
2023 · Nature CommunicationsHuatuo
- 核心成果
- 在细胞类型 × 单核苷酸双分辨率下解码调控遗传变异的统一框架;覆盖 20 种组织、44 类细胞、13,182 个候选细胞类型特异调控变异。
- 闭环定位
- 承担「信号作用的细胞 / 组织语境判定」功能,是系统机制归因的核心环节。
2025 · Nature CommunicationsOmniReg-GPT
- 核心成果
- 上海人工智能实验室 CENO 外部基准中,三个疾病分组 ClinVar F1 均列第一。
- 闭环定位
- 主力前沿 S2F 模型,承担候选压缩环节的功能证据打分,同时作为 Model + Agent 基准的基线模型。
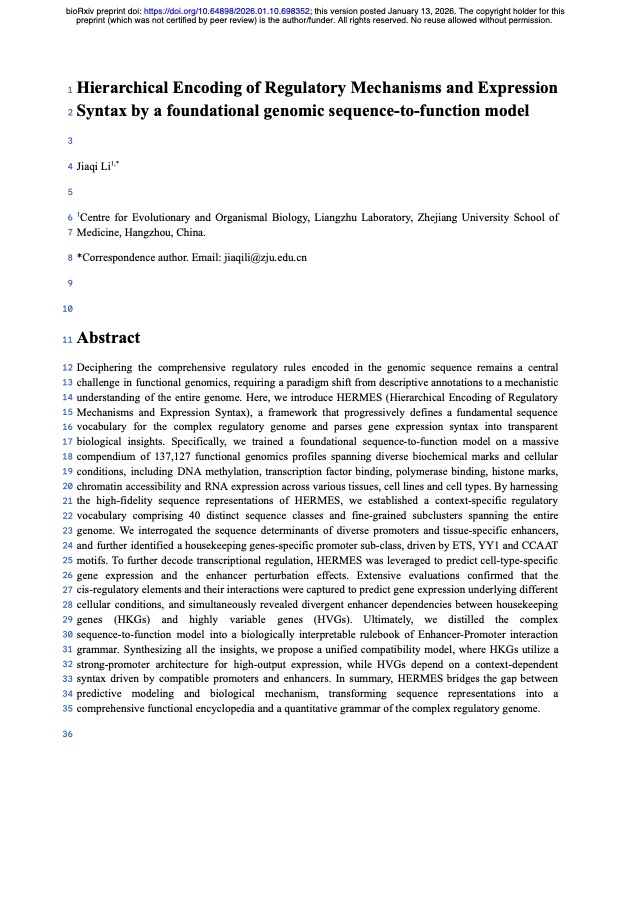
2026 · bioRxivHERMES
- 核心成果
- 迄今规模最大的 sequence-to-function 模型;将海量功能观测归纳为 40 类可解释的序列功能词表。
- 闭环定位
- Scaling 路线关键节点;40 类功能词表是机制假设可解释性的核心来源。
05 MODEL FACTORY
模型工厂:
自进化的模型生产体系
自研 AI Infra(DeepGeSeq)将模型构建过程做成可调度的生产线。人工只设定证据边界与决策门槛,Infra 自动完成「建模 → 预测 → 外部验证 → 生成训练信号 → 微调下一版」,面向疾病、组织与合作语境持续产出下一代垂类模型。
人工只设定证据边界与决策门槛,从数据规约到微调评估的全部环节由 Agent 自主完成,无需人工建模。
在人类细胞系 K562、完全独立留出的染色体测试集上,首版自动微调使 ATAC 任务 MAE 下降 91.9%,R² 由负转正。
每一个客户项目都是新的训练信号。AI Infra 已公开发表,回流的训练信号与证据边界构成不可复制的资产。
用 AI 创造 AI:K562 自动微调案例
在人类细胞系 K562 上,Agent 自主完成首版微调,在完全独立留出的染色体测试集上显著优于原始基准模型,ATAC 任务误差下降一个数量级。
- 冻结模型→
- 防泄漏划分→
- 预测→
- 候选→
- 外部验证→
- 微调→
- 冻结基准↺
| 指标(frozen chr8 · n = 2,520) | 基准模型 | Fine-tune V0 | 变化幅度 |
|---|---|---|---|
| ATAC · MAE | 5.947 | 0.482 | −91.9% |
| ATAC · R² | −182.8 | 0.469 | 由负转正 |
| ATAC · Pearson | 0.658 | 0.690 | +0.032 |
| H3K27ac · RMSE | 4.972 | 4.433 | −10.8% |
| H3K27ac · R² | 0.122 | 0.302 | +0.180 |
本案例数据与微调基础设施来自已发表的 DeepGeSeq(Bioinformatics, 2026)。AI Infra 已发表;生产线上沉淀的数据与证据边界,构成持续领先的基础。
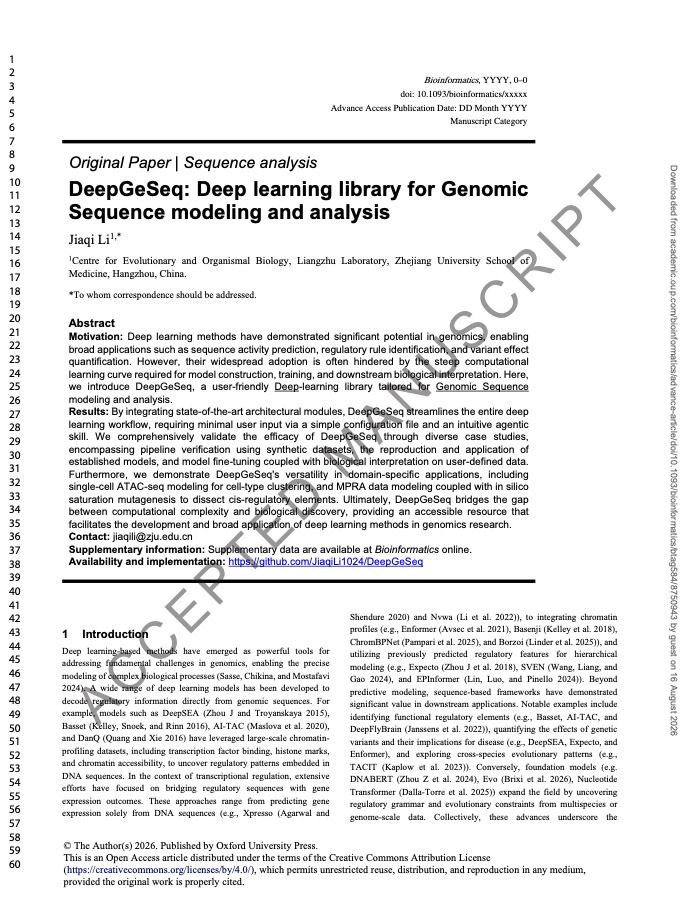
2026 · BioinformaticsDeepGeSeq
- 核心成果
- 首个内置智能体技能、支持全自然语言交互的基因组深度学习库;经 pipeline 验证、已发表模型复现与用户数据微调系统验证。
- 闭环定位
- 模型工厂执行层,可面向疾病、组织与合作语境快速生成与适配专项模型。
06 AGENT ARCHITECTURE
Agent 架构:把全球前沿模型的广度,
收敛成单一任务的判断精度
自研模型为内核,全球前沿模型为弹药。S2F Agent 以标准化契约将开放的生物学问题转化为可检查、可回归的执行流程:输入一次干预,输出机制假设、证据边界与下一步实验。
同一基准下,组合推演超越最强单模型
在冻结的冠心病基准上,结构化 Agent 相对于按验证集选出的最优单模型,Δ macro Spearman 达 +0.3282(95% CI 0.0861–0.4639),达到预设决策门槛;所有对比项均在相同数据划分、相同标签、相同指标下完成评测。
S2F Agent结构化智能体
0.215
AlphaGenome-REG | all assays全部 assay · 最强单模型
0.175
AlphaGenome-RNA | all tissues全部组织 · 单模型汇总
0.149
AlphaGenome-REG | best assay最优 assay 配置(验证集选出)
0.075
AlphaGenome-RNA | single tissue单组织配置(验证集选出)
0.036
GPN单模型
-0.089
输入
- 序列 × 组织 / 细胞语境在特定生物学语境下判断功能。
- 干预:变异 / 编辑 / 暴露变异、编辑与暴露作为并列的干预输入进入模型。
出口
- 多模态功能判断表达、可及性、进化约束同时给出。
- 支持 / 反证 / 不确定度支持与反对证据并列呈现,预测不越级为因果结论。
- 下一步实验,或明确终止输出可执行的下一步实验,或给出明确的终止理由。
S2F AGENT · CONTRACT-DRIVEN HARNESS
内核 · 自研模型
- OmniReg-GPT
- Nvwa
- Huatuo
- HERMES
弹药 · 外部前沿
- AlphaGenome
- Borzoi
- Evo 2
- GPN
PLAYBOOKS · 4 WORKFLOWS轨道预测 · 序列嵌入 · 模型微调 · 变异效应
- 01 Agent Core定义使命、路由策略与安全边界,将开放问题转化为可执行任务。
- 02 Registry输入 schema、任务契约、输出契约与恢复策略,构成机器可读的控制面。
- 03 Skills11 项模型技能:自研内核与 AlphaGenome、Borzoi、Evo 2 等外部前沿模型,模型调用细节封装在技能层。
- 04 Playbooks四类生物学工作流:轨道预测、序列嵌入、模型微调、变异效应,任务与模型解耦。
- 05 EvalsRouting、Groundedness、Task success 三项评测门槛,越权调用与无依据输出在契约层被拦截。
- 06 Runtimeroute → validate → plan → execute → verify → recover,每一步可检查、可回归。
- 用户意图→
- 路由 / 澄清→
- 校验输入→
- 生成计划→
- 执行→
- 核验产出→
- 恢复回路↺
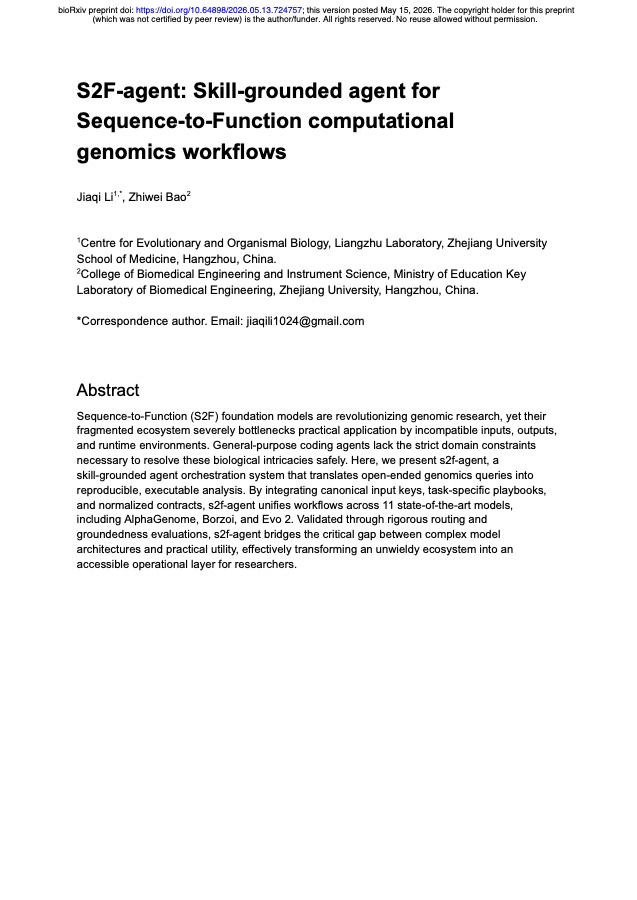
2026 · bioRxivS2F Agent
- 核心成果
- 面向 S2F 的 skill-grounded 智能体;统一编排 11 项模型技能(含 AlphaGenome、Borzoi、Evo 2),并通过 routing 与 groundedness 评测验证。
- 闭环定位
- 世界模型编排层的公开学术版本。
在 54 组配对案例上,S2F Agent 通过率 100%,通用 Agent 通过率 22.2%(McNemar 检验 p = 4.55e-13)。公开学术版本:S2F Agent(bioRxiv, 2026)。
07 PUBLIC PROOF
公开验证冠心病:从 16,607 个变异到 42 个候选,
冠心病:从 16,607 个变异到 42 个候选,
命中已验证靶点
遗传起点是 Aragam 等百万样本冠心病研究(Nature Genetics, 2022;PMID 36474045)。复杂疾病的关联空间远大于可实验空间,核心任务是从中锁定少数具备机制意义、可被干预的轴。
方法五模型交叉评分
多模型交叉评分,组织特异机制可复核
自研 OmniReg-GPT、HERMES 与 AlphaGenome、Borzoi、GPN 在同一条标准化执行链上交叉评分:组织特异调控、转录扰动、进化约束同时给出,再与 GTEx eQTL 对齐。
- 多模型交叉评分→
- 组织特异调控方向→
- eQTL / 机制对齐→
- 证据包交付
筛选流程压缩约 400×
16,607 → 42
- 16,607冠心病相关显著变异
- 42统计—功能双支持的优先候选
优先候选 · 统计与功能双支持42
每一条候选自带组织上下文(肝脏、内皮、血管)、调控方向判定与证据计数,可直接进入立项讨论。
SORT1
方法学对照:已知的肝脏脂质靶点 SORT1 在无先验提示条件下被系统独立复现,组织、基因与调控方向同时对齐,为其余新候选提供可信度锚点。
每条候选机制以「变异 → 分子事件 → 表型」链条呈现,并同时给出支持证据数、反证数、不确定度与决策结论。第一条为已公开的 PCSK9 机制,用于展示格式;其余客户项目按 NDA 脱敏。
机制 #1 · 已公开机制 · 格式示例
rs11591147 → 肝细胞 PCSK9 功能丧失 → PCSK9 活性 ↓ → LDL-C ↓ → ASCVD 风险 ↓
机制 #2 · 新候选 · 客户项目脱敏
→ 内皮细胞特异性调控失衡 → → 血管表型
以上流程与证据包格式已锁定,构成可重复交付的产品基础。
08 TYPICAL SCENES
从模型自进化到功能注释:
世界模型的跨场景验证
三个已完成的典型场景,检验同一套架构的跨任务泛化能力。覆盖模型自进化、靶点发现与功能注释。
通用基础模型无法直接解读实验室自有的功能基因组数据。S2F Agent 自主完成数据规约、微调与评估,将基因组基础模型适配为该场景的垂类模型。
在 ENCODE K562 的 ATAC 与 H3K27ac 定量谱上,hold-out 预测有效,并可从序列区分 primed 与 active 两类调控状态。
沉淀为可复用的垂类模型资产。复杂疾病的关联空间远大于可实验空间,核心任务是锁定少数具备机制意义、可被干预的轴。
冠心病案例已在上一节完整展开:多模型交叉评分、组织特异方向判定、eQTL 对齐,最终交付功能证据包。
同一流程可迁移至其他复杂疾病。功能依赖情境,注释亦然。
同一套多模态解释扩展至 25 万以上多性状 GWAS 变异,按组织、模态与性状给出分子后果。
新性状纳入同一框架,无需重写流程。09 COMPETITIVE LANDSCAPE
差异化路线,
构建技术代际优势
同类 AI 制药公司多在既有范式内优化效率,LinkX 从序列第一性原理出发,在发现入口、模型能力与交付形态三个层面形成代际差异。
多数同行的能力边界止于已观测对象。LinkX 以序列为第一性输入,覆盖非编码区、私有突变等传统方法难以触达的盲区。
自研模型登顶独立基准,AI Infra 面向每一个合作语境持续产出下一代模型,模型能力随客户项目累积持续领先。
各技术路线的交付终点均为靶点基因。LinkX 不参与下游分子设计的同质化竞争,专注变异到基因的机制归因,归因置信度直接决定靶点价值。
同业对比 COMPETITIVE LANDSCAPE
| 核心能力 | LinkX自研模型 · 轻资产交付 | insitro公开披露资本 ≈ 8 亿美元 | Relation公开披露投资 ≥ 1.01 亿美元 | Deep Genomics公开披露股权融资 ≥ 2.33 亿美元 |
|---|---|---|---|---|
| 以人类遗传学为首要发现入口 | ✓ | ✓ | ◐ | ✓ |
| 自研序列到功能模型登顶独立公开基准 | ✓ | — | — | — |
| 自研内核与外部前沿模型的统一编排 | ✓ | ◐ | ◐ | — |
| 机制优先、不锁定治疗模态的开发路线 | ✓ | ✓ | ◐ | — |
| 不依赖细胞 QTL 数据的功能预测覆盖 | ✓ | — | ◐ | ◐ |
| 轻资产嵌入客户现有数据与实验体系 | ✓ | — | — | — |
✓ 核心产品或对外交付 · ◐ 部分覆盖或主要内部使用 · — 未公开定位为标准化核心产品
融资额来源于公开信息检索,统计截至 2026 年 8 月 16 日;同业能力标注依各家公开表述归纳。
Google DeepMind 的 AlphaGenome、Arc 的 Evo 2、上海人工智能实验室的 CENO 等开放基础模型,构成 LinkX Agent 架构的弹药库:它们回答「这段序列会发生什么」,LinkX 回答「该靶点是否值得干预」。开放模型越强,组合推演的上限越高。
10 BUSINESS MODEL
面向创新药企的
靶点立项功能证据基础设施
交付可审计的功能证据包,进入药企立项决策。合作从客户既有靶点组合的系统重审切入,随后按名单批次持续交付。
商业模式
- 01买方
创新药企与转型中的传统药企,首批客户为靶点管线需要系统重审的企业。
- 02交付
可审计的功能证据包。格式锁定,更换靶点名单即可重复运行。
- 现在靶点立项的功能证据
标准化证据包进入药企立项决策。
- 随后合作回流,模型持续进化
每一次立项合作成为训练信号,世界模型随使用持续提升精度。
- 再后高确信机制上的共同 IP
同一高确信机制被反复验证后,进入联合开发与权益分配。
以项目制切入:首单以客户既有靶点组合的系统重审为对象,按靶点名单规模与交付深度定价,里程碑付费。随后转为年度框架合作,按名单批次持续交付;对高确信机制,以联合开发与 IP 分成获取长期权益。
已与多家头部创新药企启动深度对接,首批靶点重审合作洽谈推进中。
药企的靶点名单充足,立项会上可审计的功能证据稀缺。基因组基础模型今年集中开放,药企尚无能力将其转化为立项决策。LinkX 将这一步产品化。
立项决策始于同一个判断,与下游模态无关
无论小分子、抗体还是核酸药物,立项决策都始于同一个判断:该靶点是否值得干预、干预方向如何、何时终止。LinkX 提供这一判断所需的功能证据,分子设计、递送与临床验证位于其下游。
- 疾病锚定→
- 靶点确证→
- 方向判定→
- 分子设计→
- 开发与递送→
- 临床验证
LinkX 覆盖的环节
11 TEAM
核心团队
01 FOUNDER / CEO
鲍志炜
浙江大学医学院生物信息学博士、医学信息学博士后,辅修浙江大学管理学院 BEST-MBA。曾任医疗上市公司人工智能事业部负责人,从 0 到 1 打造覆盖医疗全流程的百余个 AI 产品,落地百余家三甲医院并推动数亿元有效合同;国内最大生物信息学社区 BioLinkX 创始人。现全面负责公司建设、团队管理、融资、商业策略与首批客户拓展。
02 FOUNDER / CHIEF SCIENTIST · CTO
李佳琦
浙江大学本科,浙江大学医学院 AI for Science 博士、博士后,长期聚焦单细胞基因组学、序列到功能模型与可解释调控机制研究。Nvwa、Huatuo、OmniReg-GPT、DeepGeSeq 与 S2F Agent 核心作者,代表成果发表于 Nature Genetics、Nature Communications、Bioinformatics 等顶级期刊。全面负责模型科学、技术路线、评测体系与研发团队管理。
03 CO-FOUNDER / CHIEF INNOVATION OFFICER · CIO
王傲文
浙江大学本科,浙江大学计算机科学与技术学院博士。长期深耕 AI for Life Science 前沿交叉领域,致力于大模型、底层物理化学原理与高通量基因组测序技术的深度融合,探索驱动生命科学机制发现的下一代计算范式。在计算生物学与蛋白质分子生成方向取得多项突破性成果,以第一 / 通讯作者在 Nature Communications(3 篇)等顶级期刊发表重要学术成果,另有多篇高影响力子刊在审。现全面负责生信基础模型与蛋白设计的 AI 方法学前沿探索、跨学科技术攻坚及颠覆性创新产品的工程化与落地交付。
04 CO-FOUNDER / CHIEF MEDICAL OFFICER · CMO
胡潇逸
浙江大学外科学博士,兼修生物工程,师从郑树森院士。曾任浙江大学医学院附属第一医院肝胆胰外科医师,后在翰森制药、阿斯利康主导多款新药从临床前至 III 期的全流程开发,负责中美双报与突破性疗法认定等关键监管节点,并评估 BD 资产的临床潜力与风险。现负责 LinkX 管线的临床战略与注册路径:设计关键性试验方案,统筹医学监查、药物警戒与数据安全,主导外部合作与监管沟通。
12 THE RAISE
本轮融资 2,000 万元
支持 12 个月运营,团队扩至约 10 人,用于世界模型的产品化与规模化应用;期内与 1–2 家创新药企达成付费立项合作,实现首笔收入。
资金用途与对应里程碑 TOTAL RMB 20M · 12 MONTHS
| 资金主线 | 明细科目 | 金额及占比 | 对应里程碑 |
|---|---|---|---|
| 证据包产品化与客户项目 | 格式锁定、交付流水线、首批药企项目 | 600 万 · 30.0% | 同一格式的证据包可重复交付 |
| 商务拓展与团队建设 | 关键岗位招聘、药企对接、客户成功 | 750 万 · 37.5% | 落地 1–2 家付费药企,实现首笔收入 |
| 模型工厂与算力 | 算力、云服务、数据与生产线运转 | 250 万 · 12.5% | 自进化 Infra 持续产出下一代模型 |
| 运营与基础设施 | 产品基础设施、办公行政、周期缓冲 | 400 万 · 20.0% | 覆盖交付与招聘周期波动 |
12 个月里程碑 MILESTONES · MONTH 12
格式锁定并完成首次交付的功能证据包产品。
1–2 家付费药企,至少一个完整交付案例可对外引用。
至少一个由客户项目回流训练出来的下一代垂类模型。
下一阶段:本轮验证药企为功能证据付费的意愿,下一轮验证证据包的规模化复制能力,以及模型随客户数量持续进化。
13 VISION
在 AI 时代,
无限扩展中心法则的边界
序列是生命的第一性原理,中心法则奠定了生命信息单向编译的底层规则。面对疾病高度异质性、药效个体差异显著的行业痛点,传统「人群平均」研发范式始终无法建立序列锚定功能、机制与治疗的底层体系。我们以序列为核心原点,正向打通碱基到表型的全链路映射,反向从目标表型精准推导干预靶点。当下以靶点立项验证价值,长期迈向个体基因组级精准成药,目标成为让生命可编程的底层计算基础设施。
生物学的 Scaling Law:两条曲线实现能力规模化跃迁
这一终局目标能否落地,核心取决于两条可验证、可自进化的技术曲线能否持续推进。二者共同收敛为序列到功能的底层统一语法,构成 LinkX 的技术路径。
持续扩充生物序列语料,学习序列内在的生成语法。
- 语料演进路径:参考基因组 → 人群基因组 → 多物种基因组 → 宏基因组
- 上下文长度:4 kb → 20 kb → 200 kb → 1 Mb
- 参数规模:117M → 270M → 500M → 2B+,配套 compute-optimal 算力扫描
持续扩充功能观测,沉淀序列到功能的映射。
- 功能图谱规模:当前 137,127 组(HERMES)→ 统一本体论下全量公共与私有观测数据
- 功能模态覆盖:表达、剪接、染色质、转录因子结合、甲基化、三维互作、单细胞、扰动实验
- 输出分辨率:窗口聚合 → 单碱基、增强子-基因关联、变异效应解析
底层三层语法体系 · 平台化能力的技术基石底层 Token 词表 功能语义词表 关系语法规则
三层语法构成完整的序列-功能语言体系,是未来成为行业基础设施的核心标准。
采用 BPE / k-mer / 单碱基 Token 体系,承载序列组合语法规则
覆盖启动子、增强子、转录因子结合、组蛋白状态等功能元件,对应 HERMES 定义的 40 类序列功能簇
定义增强子-启动子兼容性、基序-转录因子结合、变异效应方向等序列-功能映射逻辑